軽量ローカルLLMのすゝめ
tsubasa
幹部
こんにちは!TND幹部のtsubasaです!今回は、ローカルLLMの有名どころであるQwenを触ってみます。
ローカルLLMとは?
ローカルLLMとは、ChatGPTやClaudeのようなインターネット上で動作するLLMとは異なり、PC内のローカル環境で完結するLLMのことです。
ローカルLLMのメリット
・インターネット接続がなくても使用できる
・情報を外部に送信しないため、機密性が高い
・API代がかからず、運用コストが低い
ollamaのインストール
まずは、モデルを動かすソフトウェアであるOllamaのインストールからはじめます。
Ollamaの公式サイト https://ollama.com/
セットアップが終了したら、PowerShellで
ollama --versionこれでバージョン情報が表示されたら、インストールは完了です。
実際に使ってみる
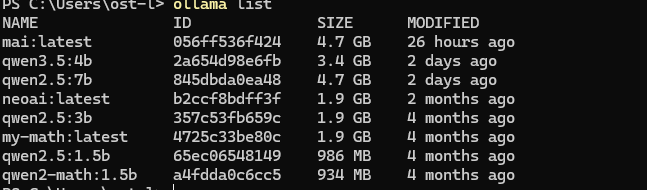
モデルのインストールはモデルの実行と同じ手順です。インストールされていないモデルを指定すると、自動でインストールを開始します。今回は、PCのスペックに合わせてQwen2.5:7bを使用します。
ollama run qwen2.5:7b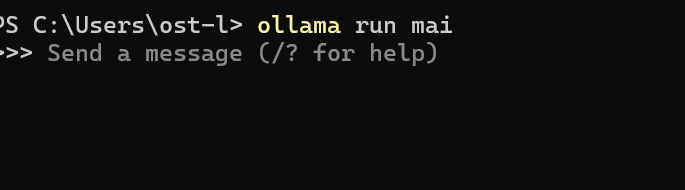
対話画面が立ち上がり、チャットでやりとりができます。
また、対話を終了したいときは
/byeと打つことで終了できます。
設定等
既存のモデルに加え、振る舞いを記述したテキストファイル(Modelfile.txt)によって、モデルの挙動を制御し、名前を付けて区別することも可能です。ここではModelfile.txtの書き方については省略します。
使ってみて気づいたこと
まずChatGPTやClaudeに慣れていると仕方のないことなのですが、どうしてもパフォーマンス不足を感じます。またModelfileの設定に従ってくれないこともあり、総じて力不足と言えるでしょう。一方でバグの発見や簡単な定理証明には十分に回答することができます。ローカルで 使えるモデル自体はもう少し先かなと感じました。
おわりに
ローカルLLMはまだ発展途上ですがそのポテンシャルは馬鹿にできないと考えています。それでは、ここまで目を通していただきありがとうございました!